エージェント時代の推論を、垂直統合で最適化する
モデルからデータセンターまでを co-design して、トークン単価を 80% 下げる
知能の上限を引き上げる事前学習(pre-training)に注目が集まりがちです。しかし、AI の導入に実際に必要なのは、学習によって決まる「知能の上限」と、推論によって「その知能を実行していく力」の両方です。
AI は、自律的にループし、継続的に処理を実行していくものへと変わりつつあります。エージェント時代の到来により、AI を実装するうえでの「推論」の構造的な重要性は、この 1 年で大きく高まりました。エージェントを本番で回せるかどうかを分けるのは、AI の知能そのものだけではなく、推論をどれだけ効率的に回せるか、推論処理の速さ(latency)と量(throughput)、この二つをどこまで伸ばせるかだと思っています。
ai& は、その推論(inference)をいかに速く、効率的に処理できるか、これを一つの開発課題として取り組んでまいりました。
その推論を製品にしたのが「ai& Inference」です。ai& Inferenceは最先端のOSSモデルと自社で事後学習した独自モデルを、自社所有の国内インフラで動かす高性能なAI推論サービスです。米Anthropicの「Claude」や米OpenAIの「GPT」シリーズなど海外フロンティアAIサービスに代わる推論の選択肢として、既存の OpenAI / Claude APIのBase URL を差し替えるだけでそのまま稼働します。高度・効率的なトークン生成手法により、AI 利用コストを最大 80%(注)下げながら、推論処理はすべて国内で完結させています。
注)一例として、Claude Opus 4.8 の単価が Input 800 円 / Output 4,000 円(100 万トークンあたり)であるのに対し、ai&(Nemotron)は Input 80 円 / Output 480 円。フロンティアモデル比で約 80% 低い水準になります(2026 年 6 月、自社調べ)。モデルごとの単価は公式サイトで公開しています。
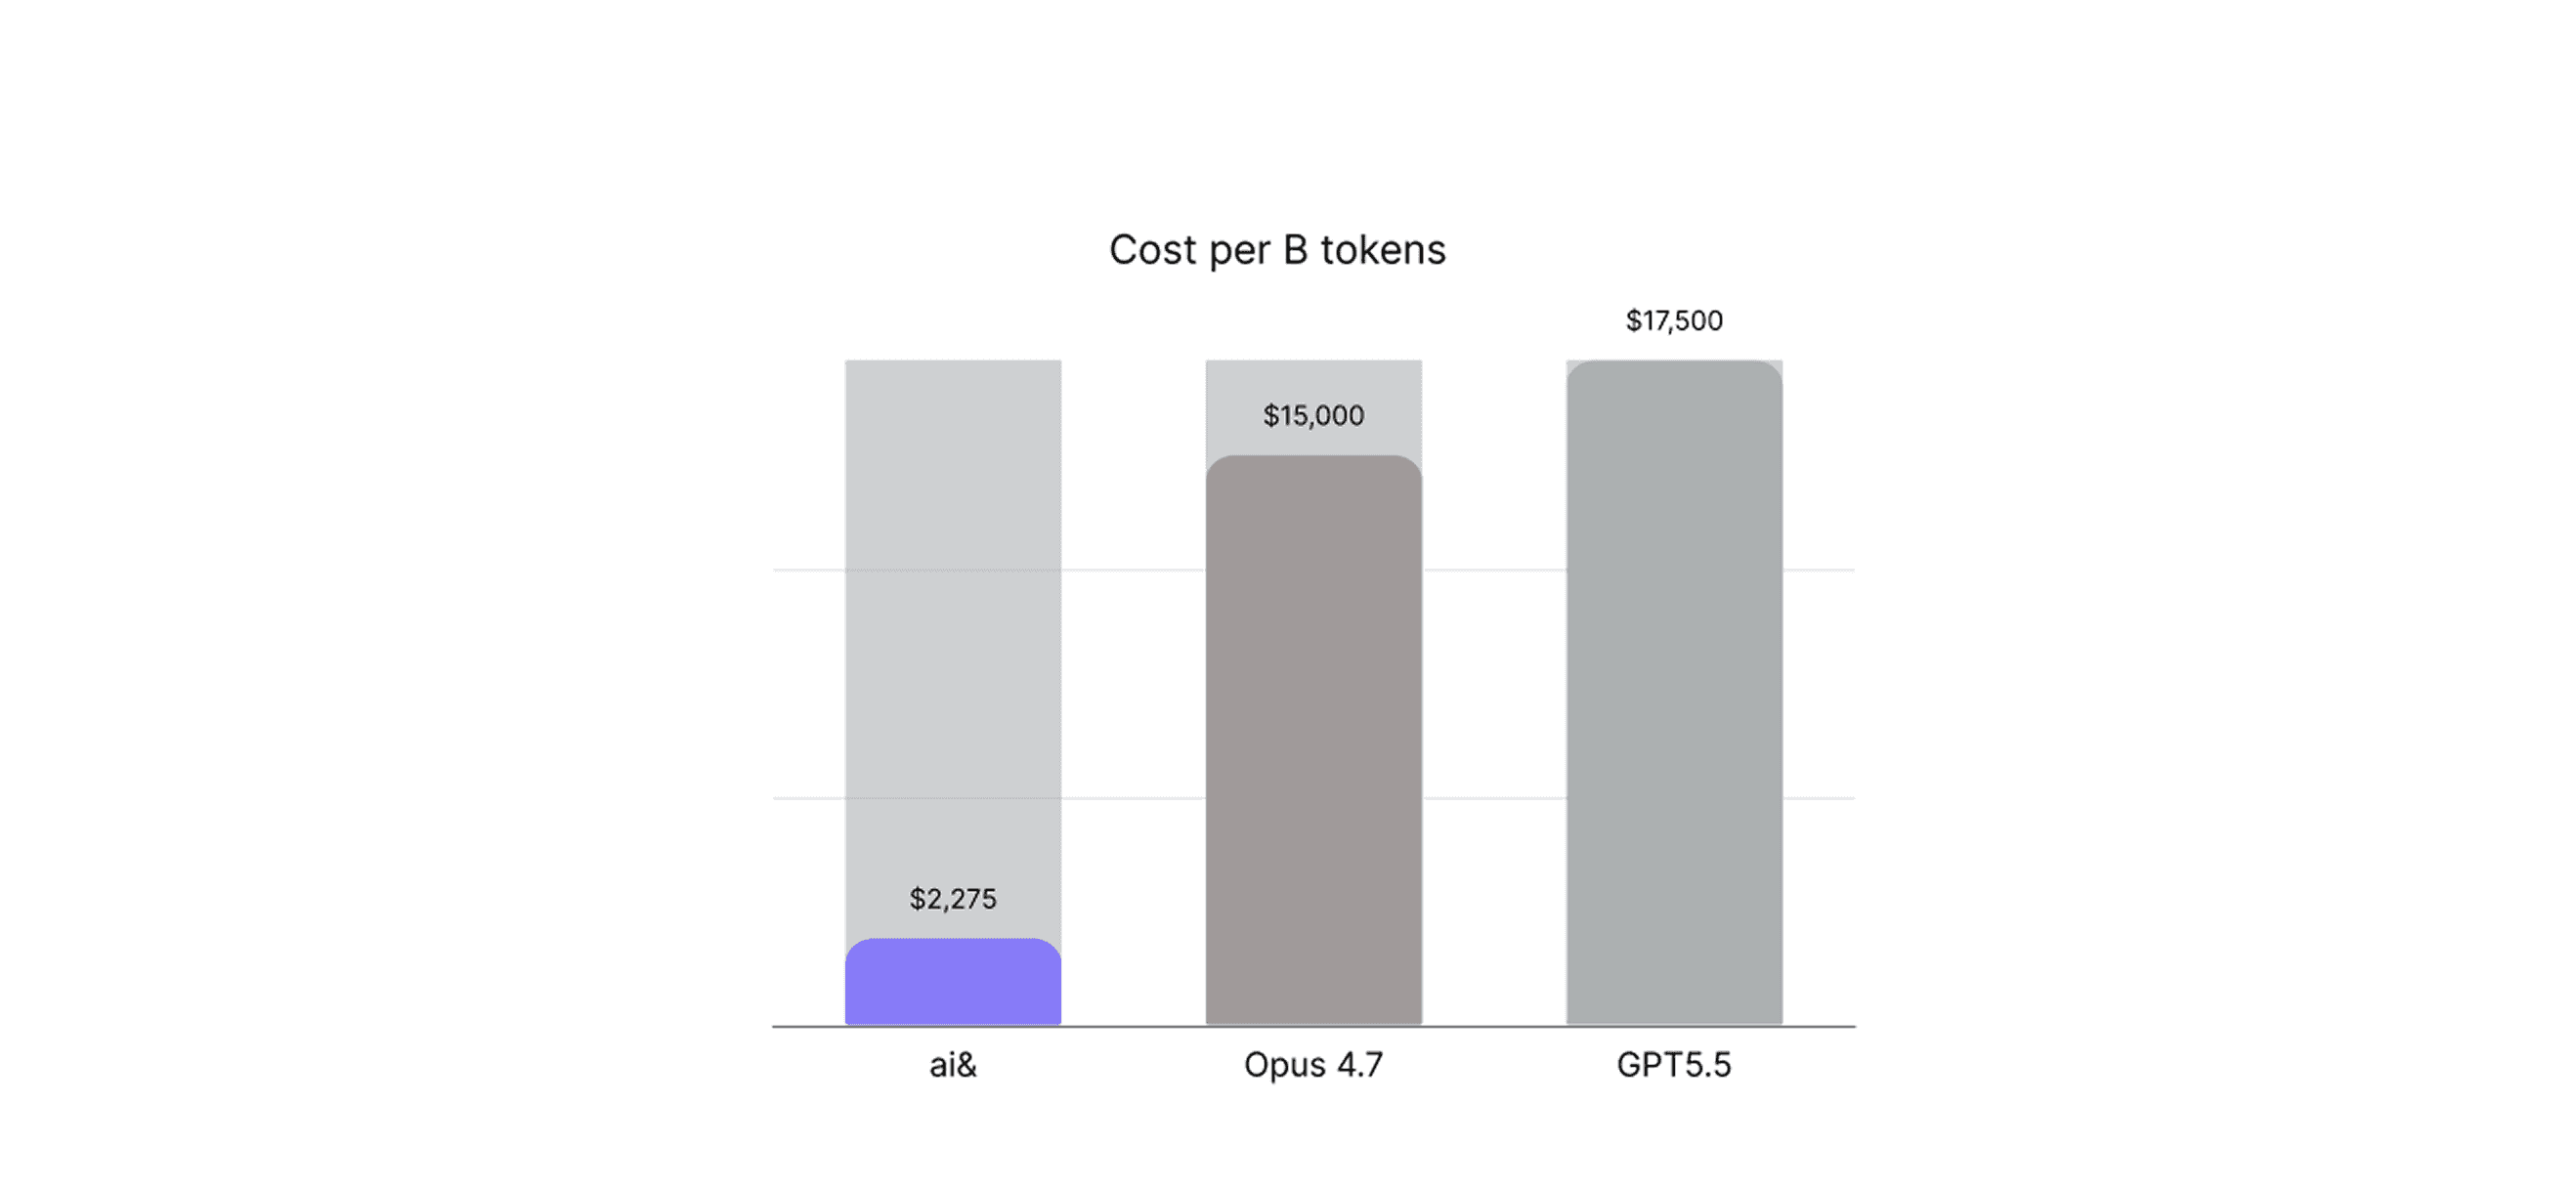
本稿では、エージェント時代の推論と、どのようにして「80%」も低い価格でトークンを提供できているのかを紹介します。
本稿の構成
Part 1: なぜ今、OpenAI / Claude だけでは足りないのか。
エージェント時代に、推論基盤の前提がどう変わったか。トークン消費量、オープンモデルの到達点、ハーネスなどについて。
Part 2:どうやって 80% のコスト差を生んでいるか。推論を「モデル / エンジン / シリコン / データセンター」の 4 層として捉え、層をまたいで co-design する考え方を説明します。中でも、私たちの差別化の中心である heterogeneous computeを掘り下げます。
Part 1: なぜ今、OpenAI / Claude だけでは足りないのか
自律エージェントが普及していくなかで、現状のProprietary API の単価のままでは、AI の本番導入は経済的に持続しません。理由を順に見ていきます。
1. トークン消費量は、チャットから 2〜3 桁跳ね上がる
従来のチャット型 AI では、1 回のやり取りで消費するトークンはせいぜい 1 万程度でした。しかし、自律的に動くエージェントは、計画立案・検索・ツール実行・結果の検証と要約といった数十から数百(並列させれば場合によっては数千)のステップをループします。1 タスクで数百万から数十億トークンを消費することも珍しくありません。
試しに概算してみます。仮に日本の一人ひとりが 100 体のエージェントを持ち、それぞれが 1 日に 100 万トークンを消費するとします。人口を約 1.2 億人とすれば、1 日あたり約 10 京(1×10^17)トークンという桁になります。もちろん、これは明日来る話ではありませんし、現在の世界の計算能力をはるかに超える需要です。ただ、方向としてはっきりしているのは、推論需要は「桁」で増えていくということです。
Google が I/O 2026 で公表した数字によれば、同社の AI プロダクト全体が処理するトークンは、月間で 2024 年 5 月の 9.7 兆から、2025 年 5 月に 480 兆、そして 2026 年 5 月には 3,200 兆(3.2 quadrillion)へと増えました。直近 1 年でおよそ 7 倍、2 年では 300 倍を超える伸びです。こうみると京というのも視野に入ってきますね。 (Reference: Google IO 2026)
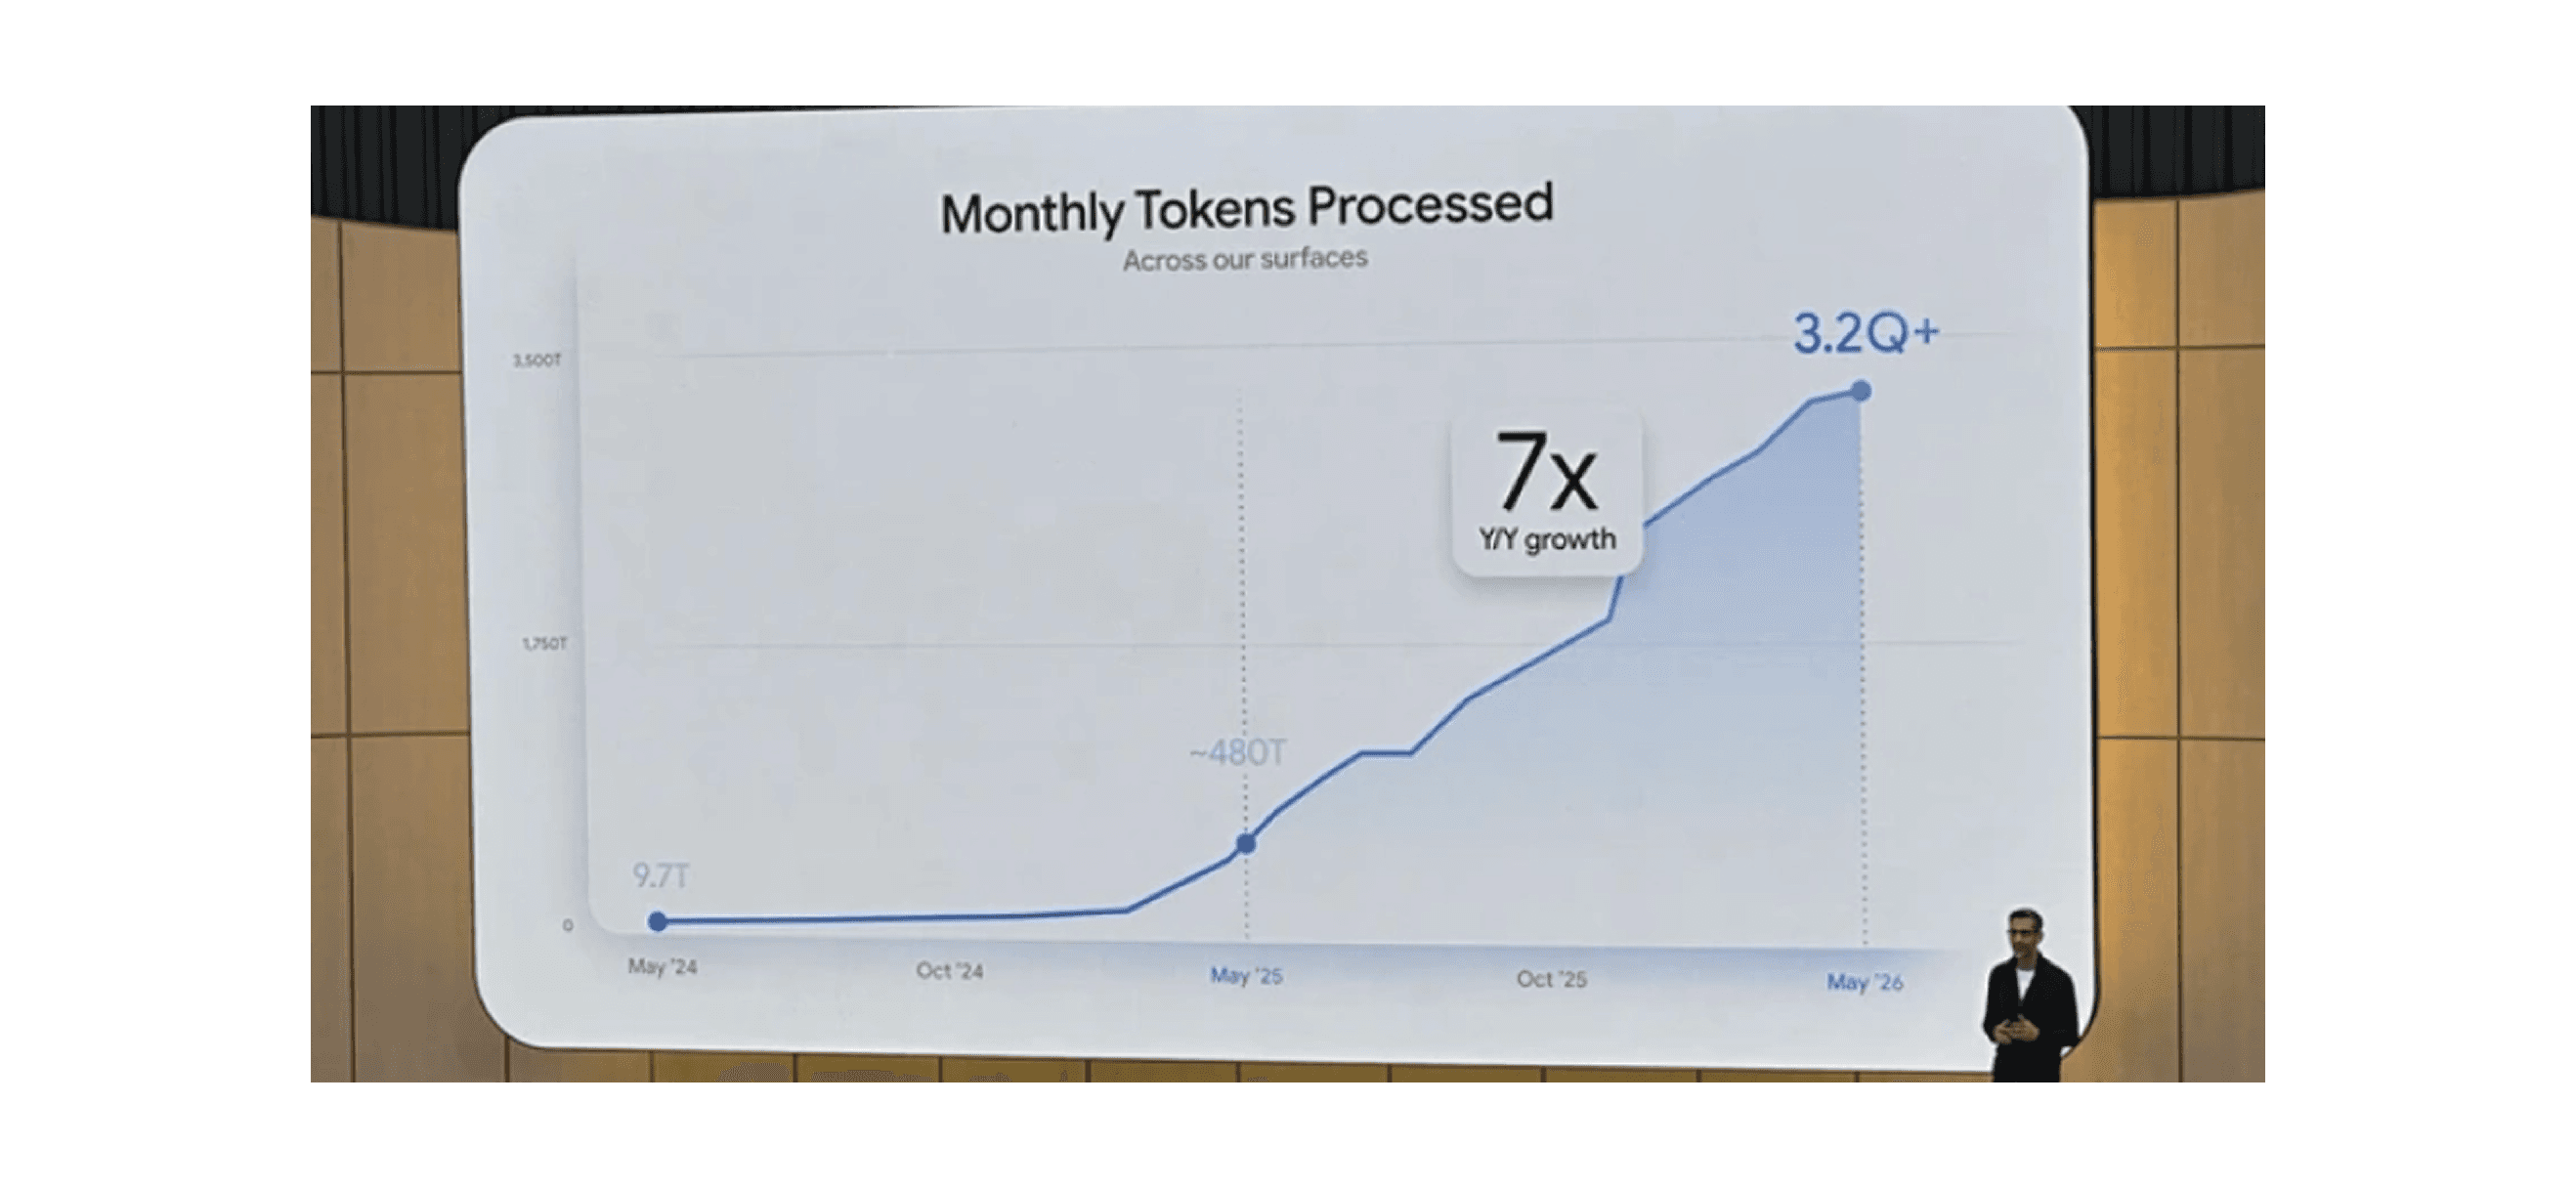
単価をフロンティアモデルのまま積み上げれば、AI コストは「経費の一部」ではなく、AIを本番投入できるかどうかを決める制約要因に変わります。
2. オープンモデルは、最先端に追いついてきた
NVIDIA Nemotron、Google Gemma、Qwen、DeepSeek、Z.AI、Moonshotといった一連のオープンモデルは、多くの用途でクローズドモデル(GPT、Claude、Geminiなど)と肩を並べる水準に達しつつあります。ベンチマークでも、上位のオープンモデルがフロンティアと僅差のスコアに並ぶ場面が増えてきました。コード生成、数学・論理推論、文書分析、構造化データの抽出、RAG、単一ステップの tool calling などがその代表例です。
研究・競技レベルの最難関の推論や、動画・音声をまたぐマルチモーダル処理など、一部の軸では依然としてクローズドモデルがリードしています。その一方、ai&が対象とする企業実務において、それらが業務の成否を分ける場面はほぼなくなってきています。コストが見通しやすく、手頃で、信頼性の高い推論を求める企業にとって、フロンティアモデルが持つ性能優位性は、オープンモデルを自社向けに運用する利点を上回らない領域に入りつつあります。
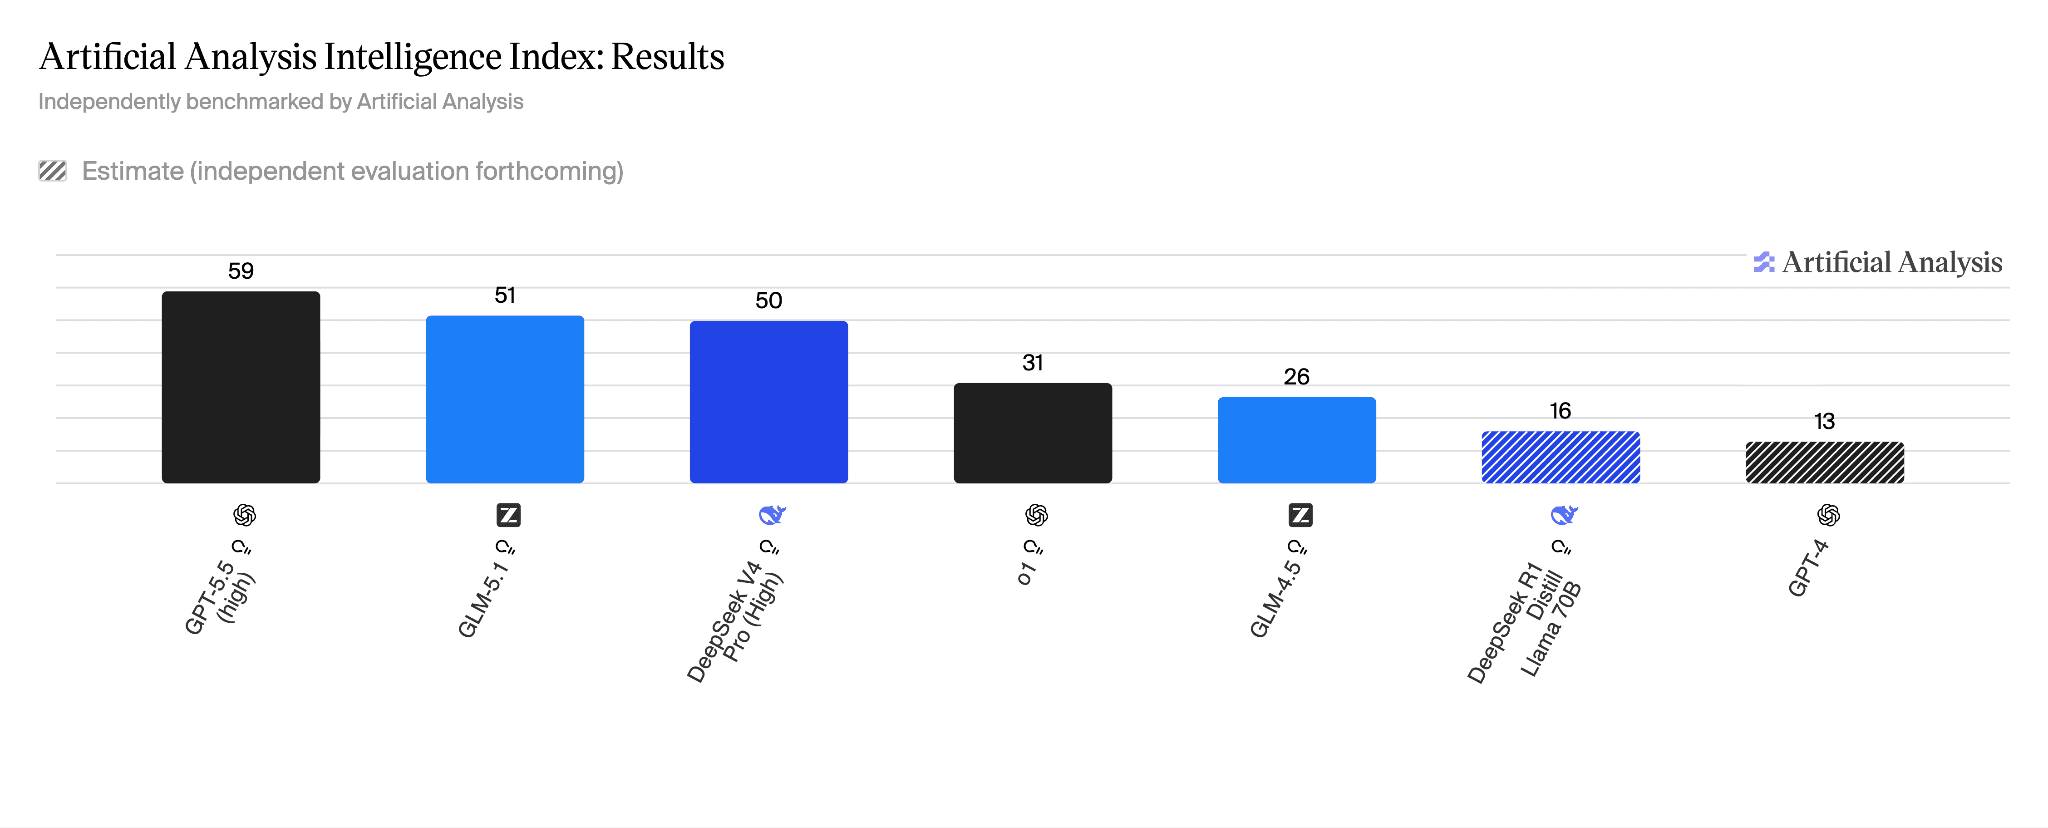
また、OpenRouter が先日発表したModel Fusionなどの手法により、OSSモデルを複数束ねたパネルが単体の GPT-5.5 や Claude Opus 4.8 を一部の領域で上回るなど、AIの能力が単体モデルの優劣だけではなくなっていることの表れかもしれません。
(Model Fusionとは、1 つのプロンプトを一つのモデルではなく複数モデルに並列で投げ、判定役のモデルが合意点・矛盾・抜けを整理したうえで最終回答をまとめる仕組みです。)
3. 推論は Pareto Frontierの上で動く、クローズドモデルでは制約的に推論性能を選べない
推論の性能は、突き詰めると二つの軸で測れます。一つは throughput(GPU 1 台が単位時間にさばけるトークン量で、実質的には 1 トークンあたりのコストを決めます)、もう一つは latency(1 ユーザーが体感する、1 秒あたりのトークン数)です。
推論の難しいところは、この二つが引っ張り合うことです。throughput を上げる手法の多くはlatency を悪化させ、逆に latency を優先すればハードウェアが遊び、throughput が落ちます。推論性能は必ずこのトレードオフの曲線(Pareto Frontier)上のどこかで動きます。
その曲線上のどこで推論を動かすかはアプリケーションによって大きく異なります。即時応答が必要な対話アシスタントなどでは throughput を犠牲にしてでも latency を優先し、逆に即時応答が不必要な文書の一括要約などでは latencyを高めthroughput を最大化するなど、アプリによって必要な推論はまるで変わります。
ここに、既存のAPI の構造的な問題があります。既存の Proprietary API では、開発者はこの調整に踏み込めません。提供事業者が定めた単一の「最大公約数的なハードウェア構成」に対して、内部はブラックボックスのまま、設定済みの価格を払い続ける構造です。そのため曲線上のどこに座るかを選ぶことすらできません。
エージェントによりトークン消費量が上がる中、どの程度の性能とコストで推論を実行するのかが、本番環境において大きな差を生みます。
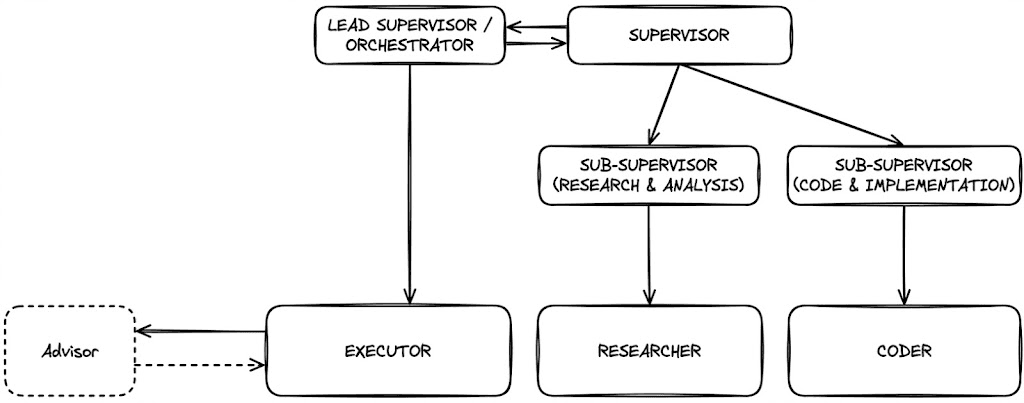
4. 主戦場は「ハーネス(統合層)」の設計に移った
オープンモデルが実務水準でクローズドモデルに追いついてきた今、モデルの素の能力(中身が GPT か Claude か、あるいはオープンモデルか)は、AI エージェントや AI 製品をつくるうえでの差別化の決め手ではなくなりつつあると考えています。
AI 製品の価値の相当部分は、モデルを取り囲む制御層(ハーネス)で決まるようになってきています。膨大な文脈から必要な情報だけを引き出す RAG パイプラインの精度、過去の対話や実行ログを保持・活用する記憶管理、どのツールをどの順序で使わせるかのプロンプト設計と経路選択など、製品付加価値の多くはここで決まります。
これらを作り込む企業に必要なのは、何でもこなす万能モデルだけではなく、自社の設計に合わせて適材適所で使えるモデルの選択肢です。複雑な推論を伴う「考える(thinking)」タスクには高度なモデルを、JSON の整形や単純な検索といった「作業する(doing)」タスクには遅延の低い軽量モデルを割り当てるなどです。推論 1 トークンあたりの消費電力は一般的にモデルのパラメータ数に比例するため、単純な「作業する」タスクに巨大モデルを当てると電力を非効率に使ってしまいます。電力が有限な日本では、それがそのまま供給できるトークン量の制約になります。
Part 1 のまとめ
ここまでをまとめます。
エージェント時代に入り、トークン消費は桁で増えてきています。そこで重要になってくるのが、推論とモデルの選択肢を幅広くもてる推論基盤そのものです。AI の知能そのものより、その知能をいかに速く・安く動かせるかが、AIの本番運用で必要になってきます。
Part 2: どのように80% のコスト差を生んでいるか
これからどのようなところに注力しコストを抑えているのかを解説します。
1. 自社インフラ
ai& は現在、約 3,000 億円の確保済み資本を背景に、日本国内で複数の 100MW 級データセンターを展開しています。建物、電力と冷却、アクセラレータ、内部の相互接続、サービング層、そして制御系(control plane)まで、そのすべてを自分たちで運用しています。一つひとつを、ハイパースケーラーや Neo-cloud のインフラを借りるのではなく、「大規模推論(inference at scale)」のためだけに立地選び、DC設計、運用をしています。
DCのキャパシティを自分たちで持つことの利点は、ユニットエコノミクスを自分たちで決められることにあり、DC基盤を端から端まで自分たちで設計できることです。どの層にも、私たち自身が当事者として立つことより推論に特化した効率的な設計を行っています。
2. heterogeneous compute ボトルネックにシリコンを合わせ、ベンダーをまたいで分離する
推論の計算は、前半と後半でまったく性質が変わります。入力を読み込む「prefill」は大きな行列積が主役であり、ボトルネックになるのは計算力(compute)です。一方、出力を 1 トークンずつ吐き出す「decode」は、毎ステップ重みをメモリから読み直すため、メモリ帯域(memory bandwidth)がボトルネックになります。同じモデルを動かしていても、前半と後半で、ハードウェアに要求する性能が正反対を向いています。
通常は、この 2 つを同じ GPU の上で動かします。ただ、同じ GPU 上で走らせると、prefill を回す間はメモリ帯域が、decode を回している間は compute が、どうしても遊んでしまいます。そこで私たちはまず、prefill と decode を別々の GPU プールに切り分けました(prefill / decode disaggregation)。こうすることで、入力長と出力長の比に応じて両プールの台数を独立に増減でき、どちらの計算資源も遊ばせずに済みます。
ここまでは業界でも知られた手法ですが、私たちの差別化はその先にあります。GPU にはそれぞれ得意・不得意があるため、prefill / decode disaggregation を同じベンダーに留めず、複数のシリコンベンダーの上で行っています。
H100 | H200 | MI300X | |
メモリ容量 | 80 GB | 141 GB | 192 GB |
メモリ帯域 | 3,352 GB/s | 4,800 GB/s | 5,300 GB/s |
FP16 / BF16 | 989 TFLOPS | 989 TFLOPS | 1,307 TFLOPS |
FP8 | 1,979 TFLOPS | 1,979 TFLOPS | 2,615 TFLOPS |
出典:SemiAnalysis
NVIDIA の Hopper や Blackwell はFLOPSに強く、計算がボトルネックになる prefill に向いています。対して AMD の MI300X は HBM の容量と帯域が大きく、メモリ帯域が効く decode に向いています。そこで私たちは、prefill のプールを計算密度の高いシリコン(NVIDIA)で、decode のプールを帯域の豊かなシリコン(AMD)で組むアプローチをとっています。それぞれの計算フェーズの数学的なボトルネックに最適なシリコンを合わせることで、単一ベンダーの構成だけでは届かないトークン単価を実現しています。
ももちろん、これには相応の技術的ハードルがあります。
メモリレイアウトの違い:prefill プールが作った KV cache を、ベンダーの異なる decode プールへ渡さなければなりません。単純なコピーでは済まないため、高速な InfiniBand と、レイアウトを揃える処理で吸収しています。
推論パスの統合:Kernel、集団通信、数値精度の扱いがベンダーごとに異なるため、それらを一本の推論パスとして破綻なくつなぐ必要があります。これは自社の推論基盤レイヤーが引き受けています。
動的な経路選択:cache の所在と各プールの負荷をリアルタイムに監視し、どのプールのどのインスタンスへ要求を流すかを瞬時に振り分けています。
この複雑さは、すべてお客様から見えない裏側で処理されます。お客様から見えるのは「単一の API の裏で、最適なシリコンに自動で割り振られている」という事実だけです。この「ベンダーをまたいで束ねる」ことはデータセンターとサーバーを自社で保有し、最下層のインフラから手を入れているからこそ成り立つものです。
3. その上に重ねる、業界標準のソフトウェア最適化
この heterogeneous compute という強固な土台の上に、私たちは業界標準のソフトウェア最適化を積み重ねています。オープンソースの推論エンジンが進化してきた現在、これら個別の技術単体では差がつきにくくなっています。真に差が出るのは、これらを「それぞれのシリコンの上で、しかもシリコンをまたいで」効かせられるかどうかです。
prefix cacheを意識した経路選択: システムプロンプトやRAGの文脈など、要求間で繰り返し現れる共通先頭(prefix)のKV cacheを再利用し、prefillコストをほぼゼロに落とします。どのインスタンスがどのcacheを持つかを把握して要求を振り分けます。
大規模なexpert parallelism(MoE): DeepSeek V4やQwen 3.5のようなMoEモデルにおいて、expertを多数のGPUに分散し、トークンごとに必要なexpertへ動的に振り分けます。MLAと組み合わせ、GPU間のall-to-all通信を最適化カーネルで抑え込んでいます。
PD分離(disaggregation): prefillとdecodeを別プールに分け、独立にスケールさせます。先述のheterogeneous computeは、これをベンダーの異なるシリコン間で行う発展形です。
speculative decoding(投機的デコード): 小さく速い下書きモデルが数トークン先を予測し、目標モデルが1回のforward passでまとめて検証します。本番要求で調整した多段カスケードにより、decodeを整数倍に加速します。
quantization(量子化): 重みを少ないビット数(NVFP4など)へ圧縮し、メモリと帯域を節約してdecodeを速くします。品質ゲートを設け、許容範囲を超える精度低下が出た構成は本番に展開しません。
肝心なのは、これらを各ハードウェアの上で個別に効かせるだけでなく、prefillに最適なシリコンとdecodeに最適なシリコン、それぞれの上で同時に効かせている点です。一つひとつの最適化が各シリコンの強みと掛け算になるからこそ、単一ベンダー・単一構成では決して届かない水準までトークン単価を下げられるのです。
ai& にしかできないこと
以下の5つの要素を同時に提供している事業者は、現時点では他に見当たりません。
国内完結のインフラ: 規制の厳しい業界にも対応可能。お客様のデータが日本管轄を離れることはありません。
日本企業向けの post-training: 日本語品質、業界用語、能力強化の各軸において、クローズドモデルに比肩する性能を達成しています。
全レイヤーを横断する処理性能エンジニアリング: cache 再利用から量子化まで、各技術の組み合わせにより、同等品質でトークン単価を約80%下げる水準を実現しています。
インフラの垂直統合: 自社データセンターと自社サーバーの運用により、計算資源とお客様の請求の間に余計なマージン層を介在させていません。
コード改修ほぼ不要の drop-in API: 既存の OpenAI / Claude 向けコードは、Base URL の書き換えだけで移行できます。
おわりに
AI による業務の変化は、まだ始まったばかりです。ただし、これを企業規模でスケールさせていくには、ソフトウェアエンジニアリングとインフラエンジニアリングの両方に、自分たちで踏み込んで詰めていく必要があります。
ai& Inference は、本日より console.aiand.com にてご利用いただけます。新規の開発者アカウントには無料クレジットも付与していますので、まずは皆さんのエージェントコードの Base URL を差し替えて、速度とコストのバランスを実際に触って確かめていただければと思います。
より高度な要件(専有キャパシティの確保、カスタムSLA、オンプレミス展開)をお求めのエンタープライズ企業様は、contact@aiand.com までお気軽にお問い合わせください。コストとインフラの制約に詰まっている日本の開発者と一緒に、次の時代のエージェントAIプロダクトを作っていければと思います。